


最近节日
正在加载日历...----
zookeeper是Yahoo开发的后来贡献给了Apache,是用于分布式管理和协调的框架。
zookeeper是Yahoo开发的后来贡献给了Apache,是用于分布式管理和协调的框架。
提供了中心化的服务:统一的配置、统一的命名、提供分布式锁,以及提供组服务
就是解压就可用,只能使用一部分功能,往往是学习阶段刚入手使用
是在一台机器上,利用多线程模拟不同的角色,来达到集群的效果,能够启动大部分功能,可以满足学习阶段使用
在多台机器上安装,每一台机器都扮演自己的角色,一般情况下生产模式中使用
解压即可,注意路径中没有中文和空格
找到conf/zoo_sample.cfg文件,复制一份更名为zoo.cfg,
zoo.cfg中有一个dataDir属性,是ZK运行期间数据的存放目录
直接双击zkServer.cmd脚本运行ZK的服务端即可
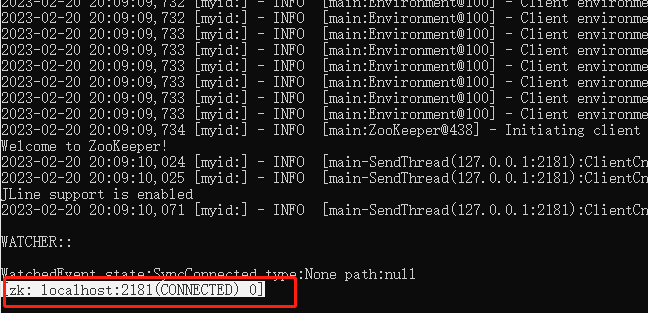
找到zkCli.cmd脚本运行ZK的客户端
| 命令 | 解释 |
|---|---|
| ls / [ls 节点名称] | 查看根节点的子节点 |
| create /video “123” | 创建节点video,并携带数据123 |
| get /video | 获取节点数据和节点详情 |
| stat /video | 获取节点详情 |
| set /video “123456” | 修改节点数据 |
| create -e /aa “aa” | 临时节点 |
| close | 关闭本次会话,但是不退出客户端 |
| connect ip | 连接到指定的服务器 |
| create -s /video | 创建持久顺序节点 |
| create -s -e /txt | 创建临时顺序节点 |
| delete /video | 删除没有子节点的节点 |
| rmr /video | 强制删除节点 |
123 节点数据cZxid = 0x2 节点的创建的事务idctime = Mon Feb 20 20:26:33 CST 2023 节点的创建时间mZxid = 0x2 节点的数据修改的事务idmtime = Mon Feb 20 20:26:33 CST 2023 节点的数据的修改时间pZxid = 0x2 子节点个数变化的事务idcversion = 0 子节点变化的次数dataVersion = 0 节点的数据变化次数aclVersion = 0 节点的权限策略变化的次数ephemeralOwner = 0x0 当前节点是否是临时节点,0是永久节点,临时节点是sessionId的dataLength = 3 节点的数据的长度numChildren = 0 当前节点的子节点的个数临时节点:主要退出本次会话就会失效
<!--添加ZK的依赖--> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.4.8</version> </dependency>package cn.tedu.csmall.cart.webapi;
import org.apache.zookeeper.*;import org.apache.zookeeper.data.Stat;import org.junit.Before;import org.junit.Test;import java.io.IOException;import java.util.List;import java.util.concurrent.CountDownLatch;
public class ZookeeperTest { private ZooKeeper zk;
@Before public void connect() throws IOException, InterruptedException { //获取zk对象 //connectString:连接ZK的ip和端口号 //sessionTimeout:会话超时时间 //Watcher:监控合格者,用于监控连接是否建立 //ZK底层是基于netty来完成连接 //netty是基于nio的异步非阻塞的通信框架 //非阻塞:无论连上与否都会向下执行 //异步:ZK可能还没有建立连接或者还在监控中,测试线程可能已经资源 final CountDownLatch cd = new CountDownLatch(1); zk=new ZooKeeper("127.0.0.1:2181", 5000, new Watcher() { @Override public void process(WatchedEvent watchedEvent) { if(watchedEvent.getState() == Event.KeeperState.SyncConnected){ System.out.println("连接成功"); cd.countDown(); } } }); //上面的连接线程执行完成之前,这个的测试线程不能执行 //即使抢到了执行权也要阻塞 cd.await(); System.out.println("finish..."); } //创建节点 @Test public void createNode() throws InterruptedException, KeeperException { //path:节点路径 //data:节点数据 //acl: 权限策略 //createMode: 创建节点的类型 //返回值是节点名 String s = zk.create("/log","hello zookeeper".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE,CreateMode.PERSISTENT); System.out.println(s); } //修改节点数据 @Test public void setData() throws InterruptedException, KeeperException { //path:节点路径 //data:节点数据 //version: 实际上指的就是dataVersion //当客户端尝试修改数据的时候,会校验version和节点的dataVersion是否一致 //如果不一致就会报错BadVersionException //如果一致直接修改 //如果不想受版本的控制,那么需要将version设置成-1 Stat stat = zk.setData("/log", "bbb".getBytes(), -1); } //查看节点数据 @Test public void getData() throws InterruptedException, KeeperException { Stat stat = new Stat(); byte[] data = zk.getData("/log", null, stat); System.out.println(new String(data)); } //获取子节点 @Test public void getNode() throws InterruptedException, KeeperException { List<String> children = zk.getChildren("/", null); System.out.println(children); } //判断节点是否存在 @Test public void exist() throws InterruptedException, KeeperException { Stat exists = zk.exists("/log", null); System.out.println(exists==null); } //删除节点 @Test public void deleteNode() throws InterruptedException, KeeperException { zk.delete("/log",-1); }}windows系统下的伪分布式
找到单机安装好的ZK,复制两份分别命名为zkServer1、zkServer2、zkServer3
ZK节点有三种角色:leader(1)、follower(n)、observer(n)
打开zkServer1中的conf下的zoo.cfg文件,添加以下内容
dataDir=D:/zookeeper/data1clientPort=2181server.1=127.0.0.1:2777:3777server.2=127.0.0.1:2888:3888server.3=127.0.0.1:2999:3999打开zkServer2中的conf下的zoo.cfg文件,添加以下内容
dataDir=D:/zookeeper/data2clientPort=2182server.1=127.0.0.1:2777:3777server.2=127.0.0.1:2888:3888server.3=127.0.0.1:2999:3999打开zkServer3中的conf下的zoo.cfg文件,添加以下内容
dataDir=D:/zookeeper/data3clientPort=2183server.1=127.0.0.1:2777:3777server.2=127.0.0.1:2888:3888server.3=127.0.0.1:2999:3999格式是 server.A=B:C:D ,A表示myid文件的内容,即zkServer的id,B表示Zk所在的地址ip,C表示leader和follower之间的通信端口,D表示选举新leader端口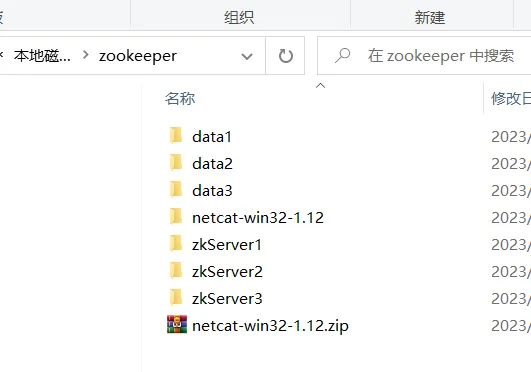
带dataDir属性指定的目录下,创建myid文件(注意没有后缀)
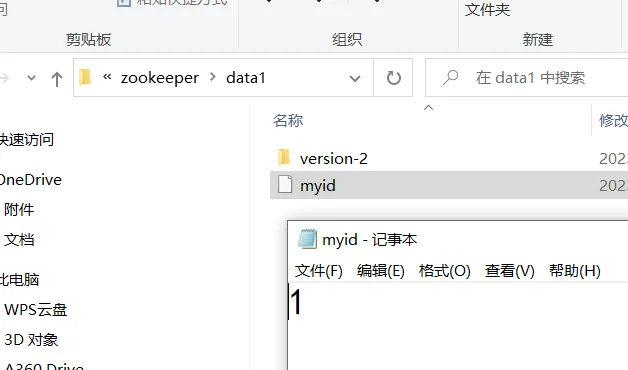
myid在zkServer1的内容: 1
myid在zkServer2的内容: 2
myid在zkServer3的内容: 3
myid中的值在集群中不允许重复
分别启动三台ZK的bin目录下的zkServer.cmd,启动期间可能会报错,忽略即可,等三台启动结束就不会在报错了
利用netcat查看三台节点的状态
**下载课前资料的netcat **,解压即可(需要注意 ,会被当成病毒,所有关闭所有的查杀软件),有一个nc.exe脚本文件,复制nc.exe到C:\Windows\System32目录下,就可以全局可用(或者配置环境变量)
通过 echo stat|nc 127.0.0.1 2181来查看该节点的状态
echo stat|nc 127.0.0.1 2181echo stat|nc 127.0.0.1 2182echo stat|nc 127.0.0.1 2183如果发送命令一直未响应,需要重启ZK集群
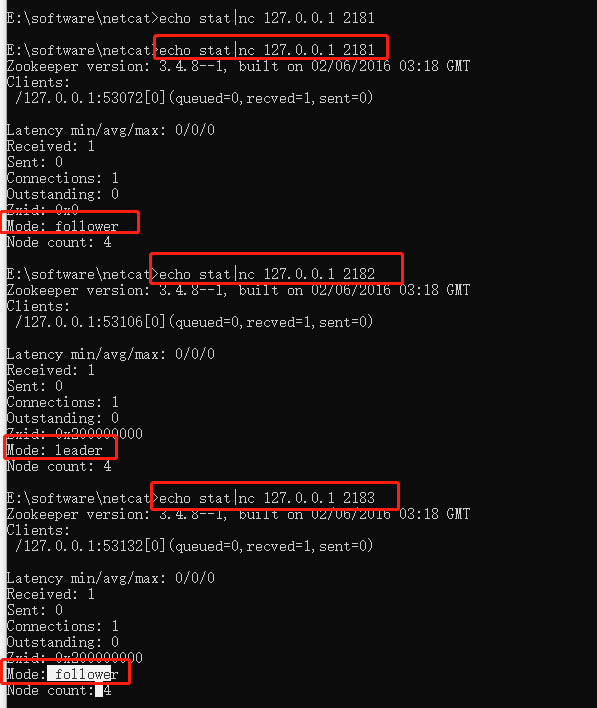
如果以上查看节点状态的命令无法使用,可以运行ZK客户端,输入
connect 127.0.0.1:2181connect 127.0.0.1:2182connect 127.0.0.1:2183如果能连接上,说明集群都没有问题
打开kafka的config目录下的server.properties
zookeeper.connect=localhost:2181,localhost:2182,localhost:2183有过半性,集群中半数以上的节点同意才能当leader
初次选举,看myid的值,谁大谁赢
非初次选举,看事务id,谁大谁赢
zk集群的容灾,也符合过半原则,ZK集群半数以上的节点存活集群才可用,所以一般情况下ZK集群是奇数台
防止脑裂,所谓脑裂就是指集群中出现两个及其以上的leader。
如果多台服务器放置在不同的机柜中,如果某一机柜突然断网,连不上,成为一个单独的个体,那么单独分出去的也会重新选举一个新的leader,又恢复网络,这个时候集群中出现了两个leader,这个就是脑裂现象
出现脑裂条件:集群产生分裂;分裂后产生选举
但是ZK集群中加入了过半性,如果分裂出去的不足一半是无法成功选举新的leader的
observer在zookeeper中即不参与选举也不参与投票,但是会监听选举和投票的结果,根据结果进行指定操作
observer可以理解成没有选举权和投票权的follower—只有干活的义务没有选举的权利
在实际开发中,当集群规模庞大(节点个数比较多)或者网络环境一般的时候,会将一个集群中90%~97%的节点设置为observer
a. 在集群规模庞大的时候,此时选举投票效率低
b. 在集群规模庞大的前提下,选举结果实际上会受网络环境的影响,如果网络环境的变化比较大,就可能会导致选举或者投票无效,从而触发新一轮的选举\投票,导致效率较低
c. 大部分节点设置成observer,可以提高效率
由于observer不参与投票也不参与选举,所以observer存活与否并不会影响整个集群是否对外提供服务。比如:21节点集群(1leader,6follower,14observer),如果四个follower宕机了,即便14个observer全部存活也不会对外提供服务了。但是如果leader和follower全部存活,14个observer全部宕机也不会影响集群对外提供服务。在ZK集群中,过半性是以能够参加选举或者投票的节点的个数来决定的。
observer的配置
a. 找打conf目录的下zoo.cfg
b. 添加server.1=B:C:D
