


最近节日
正在加载日历...----
本笔记包含:RAG 原理 → 保姆级安装部署(每步含预期输出)→ 完整源码 → 故障排查复盘
项目:Qwen3 企业知识库助手(FastAPI + 单页前端 + 本地向量库) 本笔记包含:RAG 原理 → 保姆级安装部署(每步含预期输出)→ 完整源码 → 故障排查复盘 所有报错案例均来自真实部署过程,可直接对照排错。
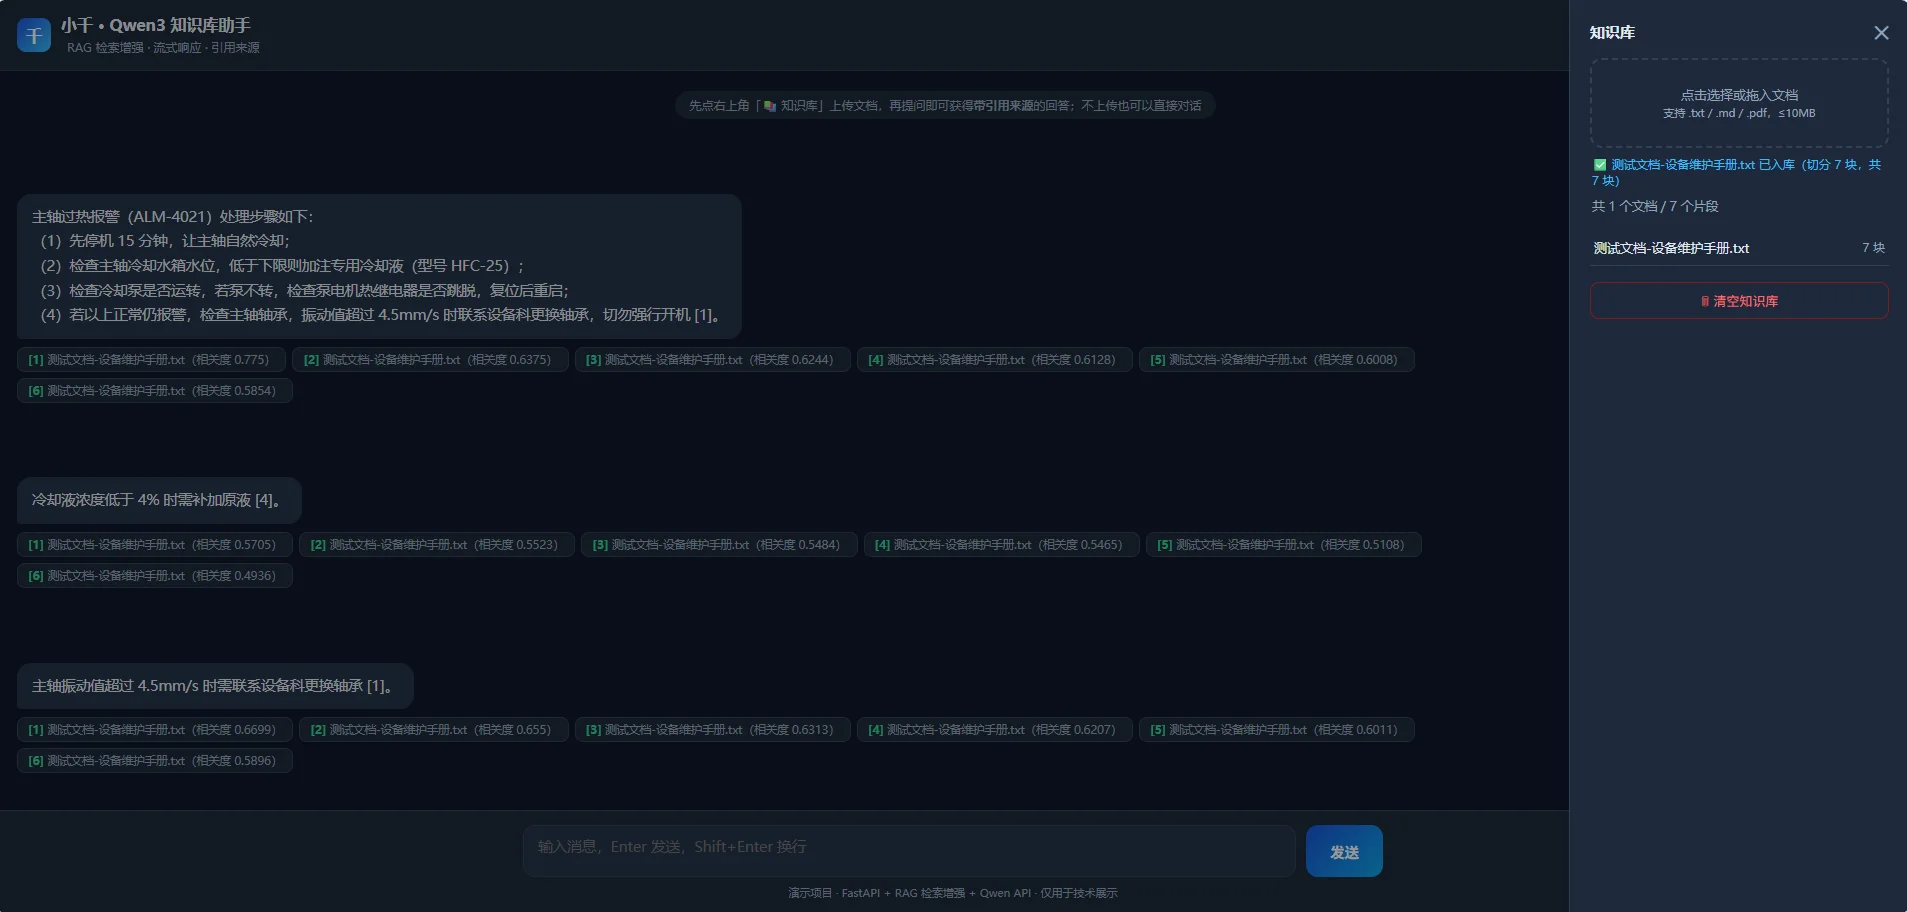
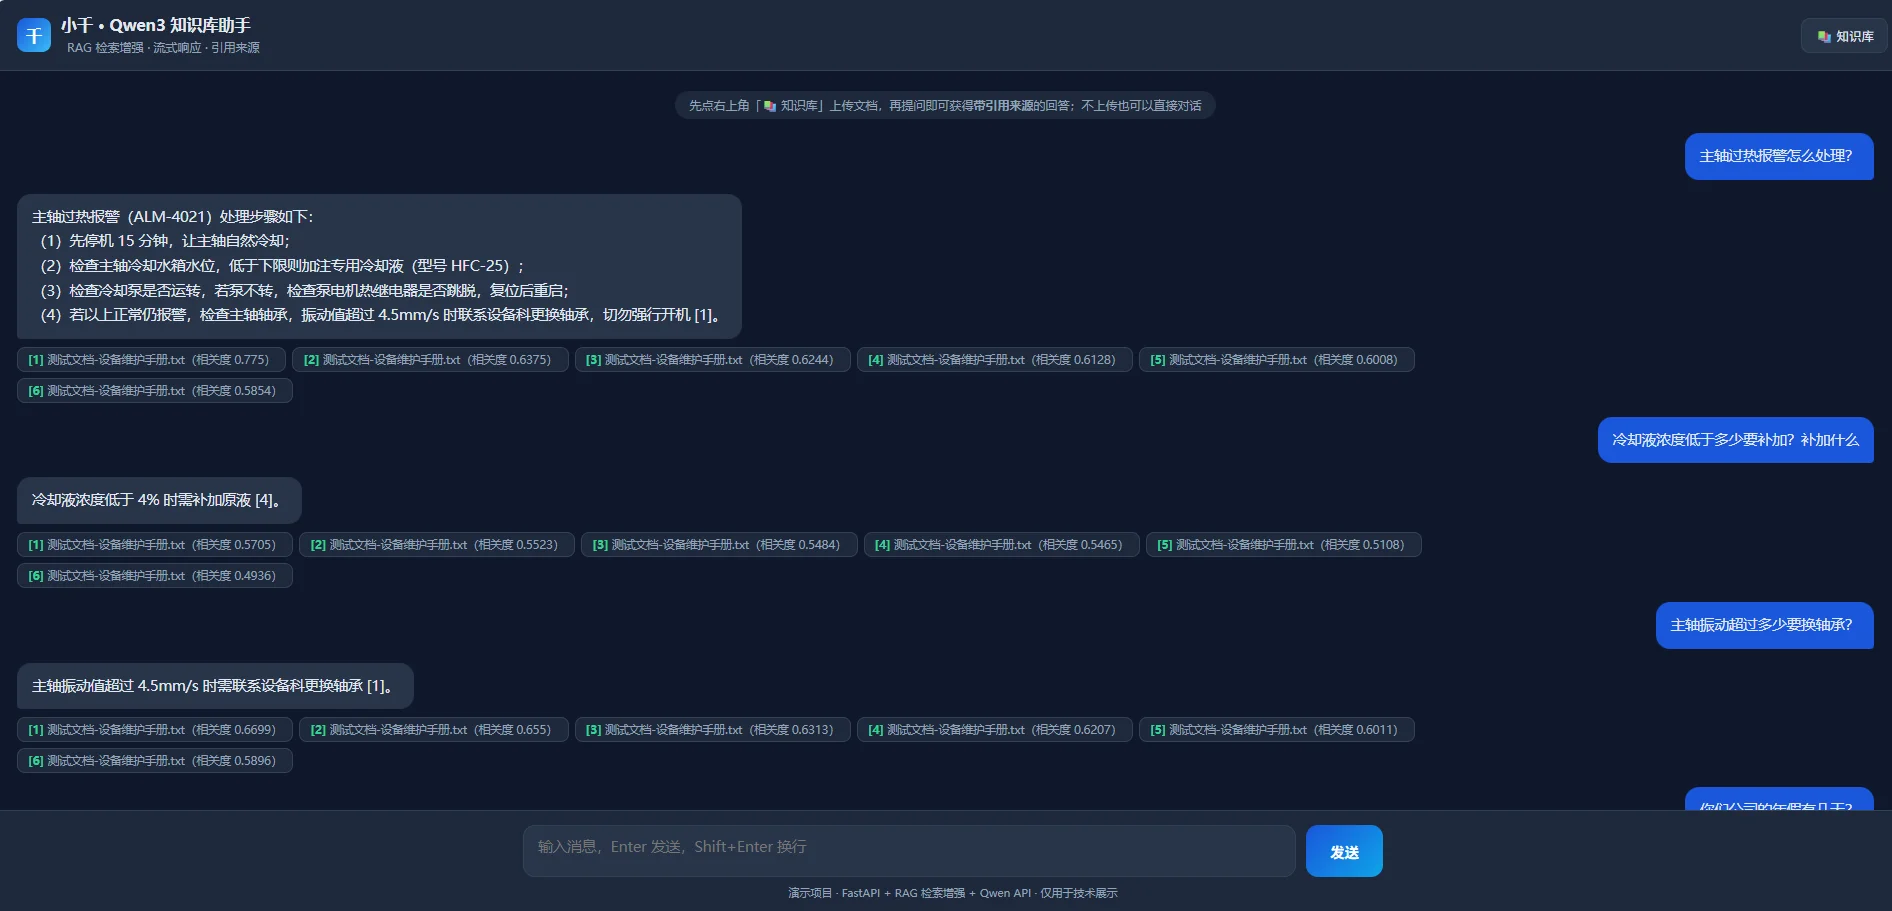
企业知识库问答系统:上传企业文档(txt/md/pdf)→ 自动切分、向量化入库 → 用户提问 → 检索相关片段 → 大模型带引用回答。支持 SSE 流式输出、多轮对话、访问令牌鉴权,一套代码可在”云端 API”与”本地 Ollama 私有化”之间一键切换。
RAG = 检索增强生成 = 先查资料,再回答(开卷考试):
用户提问 → 问题向量化 → 向量库检索 Top-6 相似片段 → 片段拼入提示词 → 大模型照着资料回答 → 附带 [1][2] 引用| 环节 | 本项目实现 |
|---|---|
| 文档解析 | txt/md 直接读,PDF 用 pypdf |
| 切分(Chunking) | 280 字符、60 重叠,按中文标点语义边界断开 |
| 向量化 | 百炼 text-embedding-v3 或本地 BGE-M3 |
| 存储 | numpy 矩阵 + JSON(生产可换 Qdrant,接口不变) |
| 检索 | 余弦相似度 Top-6,相关度 < 0.45 丢弃(防幻觉) |
| 生成 | 片段注入 system prompt,要求标注引用、找不到就明说 |
qwen3-demo/├── backend/│ ├── main.py # FastAPI 主服务(问答 / 上传 / 日报 / 调试接口)│ ├── rag_store.py # 切分 + 向量库 + 检索│ ├── report.py # 设备健康日报(数据分析 × 大模型)│ ├── data/ # equipment_data.csv 传感器数据 + 设备手册.txt│ └── requirements.txt├── frontend/index.html # 聊天界面 + 知识库侧栏 + 健康日报按钮├── deploy.sh # 服务器一键部署脚本└── README.md| 事项 | 去哪办 | 花费 |
|---|---|---|
| 云服务器 2核2G | 阿里云/腾讯云「轻量应用服务器」 | ¥50–100/年 |
| 阿里云账号 + 百炼开通 | bailian.console.aliyun.com | 免费 |
| 项目代码包 qwen3-demo.zip | 本项目仓库/构建产物 | — |
为什么 2核2G 够:服务器不跑模型,只做转发,推理在百炼云端完成。
sk- 开头 + 32 位左右字母数字,中间没有空格、点号、等号
(真实踩坑:复制错了来源,Key 里混入点号长串,部署后调用必然失败)方式 A:网页终端上传(最简单,推荐新手)
ubuntuqwen3-demo.zip 通过终端右上角文件夹(上传)图标上传/home/ubuntu/ 下方式 B:scp 命令上传(在你自己电脑的终端执行)
scp -r qwen3-demo root@服务器IP:/opt/打开网页终端,逐条复制执行(每条之间等上一条跑完):
# ① 切换到 root(提示符从 ubuntu@ 变成 root@)sudo -i# ② 安装解压工具(通常已装)apt install -y unzip# ③ 解压到 /opt(注意:文件名中间没有任何空格)unzip /home/ubuntu/qwen3-demo.zip -d /opt/✅ 预期输出:一串
creating: /opt/qwen3-demo/...和inflating: ...
# ④ 验证解压结果ls /opt/qwen3-demo/backend✅ 预期:看到
main.py rag_store.py requirements.txt
# ⑤ 配置环境变量(三条分别执行,= 后面换成你的值)export LLM_API_KEY=sk-你的百炼Keyexport ACCESS_TOKEN=起一个8位以上的访问令牌✅ 预期:没有任何输出(Linux 的惯例:没消息就是好消息) ⚠️ 手动敲
export LLM_API_KEY=,然后只粘贴 Key 本身——整行粘贴容易带进多余字符
# ⑥ 一键部署cd /opt/qwen3-demoLLM_API_KEY=$LLM_API_KEY ACCESS_TOKEN=$ACCESS_TOKEN bash deploy.sh✅ 预期:依次输出 1/5→5/5,最后打印
部署完成!浏览器访问: http://你的IP/?token=你的令牌脚本自动完成:装依赖 → 配 2G swap → systemd 常驻服务(崩溃自动拉起、开机自启)→ Nginx 托前端 + 反向代理
http://服务器IP/?token=你的令牌 → 看到”小千”聊天界面| 你看到的报错 | 原因 | 解决 |
|---|---|---|
cannot find or open /root/qwen3-demo.zip | ①命令里文件名被空格拆开 ②上传的文件在 /home/ubuntu 不在 /root | 写对 ~/qwen3-demo.zip;先 ls /home/ubuntu/ 确认位置 |
~export: command not found | export 前多了粘贴进来的 ~ 字符 | 手动敲 export LLM_API_KEY=,只粘贴 Key |
LLM_API_KEY==sk-...: command not found | 长命令整行粘贴被终端拆碎 + 多打了一个 = | 改用分步 export(见 A4-⑤) |
bash: deploy: No such file or directory | deploy .sh 中间多了空格 | 写成整体 bash deploy.sh |
unzip: cannot find ... .zip.ZIP | zip 没传上来或路径不对 | find / -name "*.zip" 2>/dev/null 找位置 |
| 浏览器打不开页面 | 安全组没放行 80 端口 | 控制台 → 防火墙/安全组 → 放行 TCP 80 |
| 回答编造文档没有的内容 | 低相关片段混入上下文 | 相似度阈值提到 0.45 + 强化提示词 |
| 文档有的内容答错/说没有 | 切分出问题(碎块/稀释) | 用 /api/debug 接口看命中片段,检查块数是否异常 |
解压时卡在 replace ...? [y]es, [n]o... 询问 | /opt 下已有旧文件,unzip 逐个询问覆盖 | 用 sudo unzip -o(-o = 直接覆盖不再询问);问号处按 Ctrl+C 退出 |
Permission denied(解压/删除 /opt 下文件) | /opt 是系统目录,普通用户 ubuntu 无写权限 | 命令前加 sudo |
| 服务反复重启,前端显示”无法连接后端” | 后端启动即崩溃(如缺依赖) | ① systemctl status qwen-api 看状态 ② journalctl -u qwen-api -n 30 --no-pager 看报错 |
日志出现 ModuleNotFoundError: No module named 'pandas' | 日报模块依赖 pandas,旧版 requirements 漏了 | sudo pip3 install pandas -i https://pypi.tuna.tsinghua.edu.cn/simple 后重启服务 |
点日报按钮返回 {"detail":"令牌错误"} | v6 前端 bug:聊天接口认请求头令牌、日报接口认 URL ?token= 参数,前端只发了前者 | 升级到 v7 前端包(日报请求已带 ?token=);部署后记得把新 index.html 拷到 /var/www/html 并 Ctrl+F5 |
| 改了前端但页面没变化 | Nginx 展示的是 /var/www/html/index.html 的拷贝,unzip 只更新了 /opt 里的原件 | sudo cp /opt/qwen3-demo/frontend/index.html /var/www/html/index.html 后 Ctrl+F5 强刷 |
网页终端粘贴长命令容易夹带字符(~、空格、换行)。三条纪律:
export,别一行贴完目的:让模型真正跑在自己电脑上(数据不出本机),也是”本地私有化部署”的演示素材。
ollama.com/download → 下载 Windows 版 → 双击安装PowerShell 执行:
ollama pull qwen3:8b # 约 5GB,网慢可以睡前挂着ollama run qwen3:8b "介绍一下你自己"→ 能流式回答即成功。
nvidia-smi→ 应看到 python 进程占用数 GB 显存 = GPU 在干活(录演示视频必带这个画面)。
断网测试:关掉 Wi-Fi 再对话 → 依然能答 = 真·本地私有化。
cd qwen3-demo\backendpip install -r requirements.txt
set LLM_BASE_URL=http://localhost:11434/v1set LLM_API_KEY=ollamaset QWEN_MODEL=qwen3:8bset EMBED_MODEL=bge-m3
uvicorn main:app --port 8000前置:
ollama pull bge-m3(嵌入模型,约 1.2GB)。 打开frontend/index.html(直接双击即可,前端会自动回退到 localhost:8000)→ 上传文档 → 带引用回答,全程不联网。
ollama pull qwen3:8b 过程(模型下载到本地)nvidia-smi 显存占用画面| 模型 | 表现 |
|---|---|
| qwen3:4b(2.6G 显存) | 完全进显卡,20–30 tok/s,丝滑 |
| qwen3:8b(5.2G 权重) | 显存+内存混合推理,6–10 tok/s,可用 |
| qwen3:14b+ | 大部分压 CPU,2–4 tok/s,不推荐演示 |
systemctl restart qwen-api # 改代码/改配置后重启journalctl -u qwen-api -f # 实时日志curl -s http://127.0.0.1:8000/api/kb # 知识库状态更新代码:重新上传 zip → unzip -o /home/ubuntu/qwen3-demo-vX.zip -d /opt/ → systemctl restart qwen-api
换 API Key / 令牌:
sed -i 's|LLM_API_KEY=.*|LLM_API_KEY=sk-新Key|' /etc/systemd/system/qwen-api.servicesed -i 's/ACCESS_TOKEN=.*/ACCESS_TOKEN=新令牌/' /etc/systemd/system/qwen-api.servicesystemctl daemon-reload && systemctl restart qwen-api改了切分逻辑后:必须「清空知识库」重新上传文档(旧向量是旧切分生成的,不重建无效)
知识库防重复:同一文档重复上传会追加入库不去重——重传前先清空
把”传感器数据分析”和”大模型解读”串成完整业务闭环 —— Pandas 算指标 → 检索手册建议 → 大模型写给车间主任看的日报。 这是整个项目里最能体现「制造业 + AI」岗位匹配度的功能,面试必讲。
做纯 RAG 问答(上传手册→提问→回答)只能证明”会调 API”,而工厂场景的真实痛点是:
本功能把它们串成一条自动链路:数据自己会说话,模型负责”翻译”成人话。这正是 FDE(制造业方向)岗位的核心工作:懂产线 + 会用 AI 解决真实问题。
传感器 CSV ──► ①清洗 ──► ②双规则异常检测 ──► ③汇总 24h 指标 │ 设备手册.txt ──► ④关键词检索处置建议 │ ▼ ⑤大模型生成自然语言日报(qwen-turbo)关键认知:大模型不连传感器。它待在链路最上层,吃的是已经变成文本/表格的数据;采集层(PLC/Modbus/网关/SCADA)属于工业物联网范畴,两者通过数据库或文件交接。
对应代码两份(同一套逻辑,两种载体):
| 载体 | 文件 | 用途 |
|---|---|---|
| 融合版 | backend/report.py | 挂在 FastAPI 上,前端点按钮即出日报(接口 /api/report) |
| 独立脚本 | device-analytics/daily_report.py | 命令行跑,配合 cron 定时推送 |
def _clean(df: pd.DataFrame) -> pd.DataFrame: df = df.drop_duplicates() # 去重复采集 for col in ["temperature", "vibration", "current"]: df.loc[df[col] == 0, col] = np.nan # 0 值是断线,不是真 0 df = df.sort_values(["machine_id", "timestamp"]) for col in ["temperature", "vibration", "current"]: df[col] = df.groupby("machine_id")[col].transform( # 关键:transform lambda s: s.interpolate(limit_direction="both").fillna(s.median()) ) return df三个要点(面试追问高发区):
NaN;groupby("machine_id");transform 而不是 apply:Pandas 新版本里 groupby().apply() 会丢失分组列(machine_id 列消失,后续逻辑直接报 KeyError),transform 返回与原表同索引的 Series,赋值回列天然对齐 —— 真实踩过的坑。WINDOW, SIGMA = 48, 3.0THRESH = {"vib_high": 4.5, "temp_high": 75.0}
# 规则 1:固定阈值(老师傅经验)df["rule_alert"] = (df["temperature"] > 75) | (df["vibration"] > 4.5)
# 规则 2:滚动 3σ(跟自己比,能抓"慢性劣化")m = g[col].rolling(48, min_periods=24).mean()s = g[col].rolling(48, min_periods=24).std()z = (当前值 - m) / sg["sigma_alert"] = (temperature_z.abs() > 3) | (vibration_z.abs() > 3)
df["alert"] = df["rule_alert"] | df["sigma_alert"] # 任一触发即算异常为什么两条规则都要:
| 固定阈值 | 滚动 3σ | |
|---|---|---|
| 原理 | 超过绝对标准 | 偏离自身近期水平超过 3 个标准差 |
| 擅长抓 | 突发性超标(如温度冲到 80℃) | 慢性劣化(轴承磨损:每天涨一点点,永远不超阈值) |
| 弱点 | 抓不到缓变 | 对正常波动的机器偶有误报 |
窗口大小的权衡(实测验证过):窗口太小(如 6 点),均值/方差被当前值主导,计算不准、误报多;窗口太大,劣化趋势被”摊薄”,报警延迟,等于无效数据。实测 48 点 +
min_periods=24半窗起步,效果最平衡。
latest = df[df["timestamp"] >= df["timestamp"].max() - pd.Timedelta(hours=23)]prev = df[(df["machine_id"] == mid) & (df["timestamp"] < df["timestamp"].max() - pd.Timedelta(hours=24))]item = { "设备": mid, "平均温度": round(g["temperature"].mean(), 1), "最高振动": round(g["vibration"].max(), 2), "振动环比": f"{(vib_now - vib_prev) / vib_prev * 100:+.1f}%", # 环比前一个 24h "产量": int(g["output_count"].sum()), "异常次数": int(g["alert"].sum()),}# 三档风险分级if 异常次数 >= 8 or 最高振动 > 5.3: 风险 = "高风险"elif 异常次数 >= 3 or 最高振动 > 4.0: 风险 = "关注"else: 风险 = "正常"def lookup_manual(keyword: str) -> str: text = open(MANUAL, encoding="utf-8").read() for block in text.split("\n\n"): if keyword in block: return block.strip()[:300] return ""
# 触发逻辑:温度异常查「主轴过热」段落,振动异常查「振动」段落tip = lookup_manual("主轴过热") if m["平均温度"] > 60 else lookup_manual("振动")设计意图:日报不能只有”振动高了”,还得告诉车间主任该干什么(点检哪一项、加什么油、多少压力)。这里是轻量关键词检索;知识库模块的向量 RAG(余弦检索 + 0.45 阈值)是它的升级版 —— 两个版本都做过,面试可以对比讲。
prompt = ( "你是工厂设备管理员助手。根据以下设备监控数据,写一份给车间主任看的《设备健康日报》。\n" "要求:① 先一句话说总体情况;② 高风险设备单独列出问题和建议动作;" "③ 语言简洁、面向一线,不要堆砌术语;④ 不超过 300 字。\n\n" f"监控数据:\n{body}\n" + ("\n参考建议:\n" + "\n".join(hints) if hints else ""))防幻觉三板斧(和 RAG 问答模块同一思路):
容错降级设计(工程素养体现):
LLM_API_KEY → 只输出结构化数据,不报错;| 设备 | 平均温度 | 最高振动 | 振动环比 | 异常次数 | 风险 |
|---|---|---|---|---|---|
| CNC-01 | 55.3℃ | 3.04 | -1.9% | 0 | 🟢 正常 |
| CNC-02 | 65.0℃ | 6.44 | +97.6% | 23 | 🔴 高风险 |
| CNC-03 | 54.9℃ | 5.09 | +3.2% | 1 | 🟡 关注 |
验证点:generate_data.py 在 CNC-02 的数据里埋了一个”轴承渐进劣化”剧本(振动逐日抬升),系统成功捕获 —— 振动环比 +97.6%、异常 23 次,判为高风险。这说明 3σ 检测 + 环比指标的组合确实能抓慢性故障。
大模型据此生成的日报示例:
“今日 3 台设备中 CNC-02 存在高风险:振动环比上升 97.6%、平均温度升至 65℃,建议检查主轴轴承,参考手册 2.1 节处置流程;CNC-03 需关注,CNC-01 正常。”
方式 1:网页点按钮(融合版)
前端「📊 设备健康日报」按钮 → 调 GET /api/report?token=令牌 → 同页展示结构化指标 + AI 日报全文。
curl "http://服务器IP/api/report?token=你的令牌"# 返回 {"summary": {...}, "report": "……日报全文……"}方式 2:命令行手动跑(独立脚本)
cd device-analyticspython3 daily_report.py # 无 Key 也能跑(只出结构化数据)
# 云端百炼export LLM_API_KEY=sk-xxx && python3 daily_report.py
# 本地 Ollama(数据不出本机,适合保密车间)export LLM_BASE_URL=http://localhost:11434/v1 LLM_API_KEY=ollama QWEN_MODEL=qwen3:8bpython3 daily_report.py方式 3:cron 每天自动生成 + 企业微信推送
crontab -e# 每天 07:30 生成日报并推送到企业微信群机器人30 7 * * * cd /opt/device-analytics && /usr/bin/python3 daily_report.py >> /var/log/daily_report.log 2>&1推送思路:拿到日报文本后 requests.post(企微webhook, {"msgtype": "text", "text": {"content": 日报}}),车间主任每天早班在群里直接看到。
| # | 现象 | 根因 | 修复 |
|---|---|---|---|
| 1 | groupby 之后 machine_id 列消失,后续 KeyError | Pandas 新版 groupby().apply() 丢失分组列 | 改用 groupby(...).transform(...),索引天然对齐 |
| 2 | matplotlib 中文全是方框 | 系统无中文字体,且字体族名不是想当然的名字 | fontManager.addfont() 注册 NotoSansCJK-Regular.ttc,族名实际是 Noto Sans CJK JP |
| 3 | 窗口调小后误报连篇 / 调大后报警滞后 | 滚动窗口过短统计量失真,过长摊薄趋势 | 定 48 点 + min_periods=24,并加环比指标补偿灵敏度 |
| 4 | report.py 读不到 CSV(backend/data/data 嵌套路径) | 打包时数据目录嵌套了一层 | 移动到 backend/data/,路径统一用 os.path.dirname(os.path.abspath(__file__)) 相对定位 |
| 5 | 部署后服务反复重启 | requirements.txt 漏了 pandas,日报模块 import 即崩 | 补装 pip3 install pandas,并把 pandas 写回 requirements.txt |
| 6 | 点日报按钮返回”令牌错误” | 前端把令牌放请求头,而 /api/report 只认 URL ?token= 参数 | v7 前端修复:日报请求改为 "/api/report?token=" + encodeURIComponent(TOKEN) |
经验:鉴权方式要全接口统一。聊天接口用
Depends(require_token)读请求头,日报/调试接口却手写读 URL 参数,两套写法并存就埋了这种 bug——重构时应统一为一个依赖项。
“我做过一个设备健康日报功能,解决的是工厂里数据没人看、经验传不下去的问题。链路是:传感器 CSV 先做清洗——0 值当断线缺失处理、按设备分组插值;然后双规则异常检测——固定阈值抓突发超标,滚动 3σ 抓慢性劣化,比如轴承磨损每天涨一点,固定阈值永远报警不了,3σ 就能抓到;接着汇总最近 24 小时指标,算振动环比;再从设备手册检索处置建议;最后让大模型把结构化数据翻译成给车间主任看的 300 字日报。数字全部由 Pandas 计算,模型只负责组织语言,所以不会幻觉出错误数据。我还做了降级:模型挂了就直接输出结构化数据,日报不断。真实数据里埋了一个轴承劣化剧本,系统成功抓到 CNC-02 振动环比涨了 97.6%,判为高风险。”
高频追问预案:
"""Qwen3 演示项目 - 后端(含 RAG 知识库)两种模式(环境变量切换):云端 API / 本地 Ollama 私有化"""import ioimport jsonimport os
import httpxfrom fastapi import Depends, FastAPI, Header, HTTPException, UploadFilefrom fastapi.middleware.cors import CORSMiddlewarefrom fastapi.responses import StreamingResponsefrom pydantic import BaseModel, Field
from rag_store import VectorStore, chunk_text
# ---------------- 配置 ----------------LLM_BASE_URL = os.getenv("LLM_BASE_URL", "https://dashscope.aliyuncs.com/compatible-mode/v1")LLM_API_KEY = os.getenv("LLM_API_KEY", os.getenv("DASHSCOPE_API_KEY", ""))CHAT_MODEL = os.getenv("QWEN_MODEL", "qwen-turbo")EMBED_MODEL = os.getenv("EMBED_MODEL", "text-embedding-v3")CHAT_URL = f"{LLM_BASE_URL}/chat/completions"EMBED_URL = f"{LLM_BASE_URL}/embeddings"ALLOWED_EXT = {".txt", ".md", ".pdf"}# 公网部署必配:设置后所有 /api/* 请求需携带 X-Access-Token 头ACCESS_TOKEN = os.getenv("ACCESS_TOKEN", "")
def require_token(x_token: str | None = Header(default=None, alias="X-Access-Token")): if ACCESS_TOKEN and x_token != ACCESS_TOKEN: raise HTTPException(401, "缺少或错误的访问令牌(联系管理员获取)")
app = FastAPI(title="Qwen3 RAG Demo API")app.add_middleware( CORSMiddleware, allow_origins=["*"], allow_methods=["*"], allow_headers=["*"])
kb = VectorStore()kb.load()
# ---------------- 基础工具 ----------------async def embed_texts(texts: list[str]) -> list[list[float]]: """批量向量化(百炼单次最多 10 条,分批调用)。""" out: list[list[float]] = [] async with httpx.AsyncClient(timeout=60) as client: for i in range(0, len(texts), 10): r = await client.post( EMBED_URL, headers={"Authorization": f"Bearer {LLM_API_KEY}"}, json={"model": EMBED_MODEL, "input": texts[i : i + 10]}, ) if r.status_code != 200: raise HTTPException(502, f"向量化失败: {r.text[:300]}") items = r.json()["data"] out += [item["embedding"] for item in sorted(items, key=lambda x: x["index"])] return out
def extract_pdf(data: bytes) -> str: try: from pypdf import PdfReader except ImportError: raise HTTPException(500, "服务器未安装 pypdf(pip install pypdf)") reader = PdfReader(io.BytesIO(data)) return "\n".join(page.extract_text() or "" for page in reader.pages)
def extract_text(filename: str, data: bytes) -> str: ext = os.path.splitext(filename)[1].lower() if ext not in ALLOWED_EXT: raise HTTPException(400, f"仅支持 {'/'.join(ALLOWED_EXT)} 格式") if ext == ".pdf": return extract_pdf(data) return data.decode("utf-8", errors="ignore")
# ---------------- 接口 ----------------class ChatMessage(BaseModel): role: str = Field(pattern="^(system|user|assistant)$") content: str
class ChatRequest(BaseModel): messages: list[ChatMessage] max_tokens: int = 1024
@app.get("/api/health")def health(): return {"status": "ok", "model": CHAT_MODEL, "kb_chunks": kb.count}
@app.post("/api/upload")async def upload(file: UploadFile, _=Depends(require_token)): if not LLM_API_KEY: raise HTTPException(500, "服务端未配置 LLM_API_KEY") data = await file.read() if len(data) > 10 * 1024 * 1024: raise HTTPException(400, "文件超过 10MB 限制") text = extract_text(file.filename, data) if len(text.strip()) < 10: raise HTTPException(400, "未能提取到有效文本内容") chunks = chunk_text(text) vectors = await embed_texts(chunks) n = kb.add(file.filename, chunks, vectors) return {"doc": file.filename, "chunks": n, "kb_total_chunks": kb.count}
@app.get("/api/kb")def kb_status(): docs = {} for m in kb.meta: d = docs.setdefault(m["doc_id"], {"name": m["name"], "chunks": 0}) d["chunks"] += 1 return {"total_chunks": kb.count, "docs": list(docs.values())}
@app.delete("/api/kb")def kb_clear(): kb.clear() return {"status": "cleared"}
@app.get("/api/debug")async def debug_search(q: str, token: str = ""): """调试接口:透视某问题的检索命中片段(排查 RAG 问题的关键工具)""" if ACCESS_TOKEN and token != ACCESS_TOKEN: raise HTTPException(401, "令牌错误") if kb.count == 0: return {"q": q, "kb_chunks": 0, "hits": []} q_vec = (await embed_texts([q]))[0] hits = kb.search(q_vec, top_k=6) return { "q": q, "kb_chunks": kb.count, "hits": [{"score": h["score"], "text": h["text"][:150]} for h in hits], }
@app.post("/api/chat")async def chat(req: ChatRequest, _=Depends(require_token)): if not LLM_API_KEY: raise HTTPException(500, "服务端未配置 LLM_API_KEY") last_user = next((m.content for m in reversed(req.messages) if m.role == "user"), "") if not last_user: raise HTTPException(400, "缺少用户消息")
# ---- RAG 检索 ---- sources, context_block = [], "" if kb.count > 0: q_vec = (await embed_texts([last_user]))[0] hits = kb.search(q_vec, top_k=6) if hits: refs = "\n\n".join( f"[{i + 1}] (来源:{h['name']})\n{h['text']}" for i, h in enumerate(hits) ) context_block = ( f"以下是知识库中检索到的参考资料:\n\n{refs}\n\n" "回答要求(必须严格遵守):\n" "1. 只能依据参考资料回答具体问题;若参考资料中找不到答案," "必须第一句就说明「知识库中没有相关内容」,不得编造数字或事实;\n" "2. 依据资料回答时,在对应内容后标注引用序号,如 [1];\n" "3. 参考资料与问题无关时,忽略资料,不要引用。" ) sources = [ {"idx": i + 1, "name": h["name"], "score": h["score"], "snippet": h["text"][:120] + ("…" if len(h["text"]) > 120 else "")} for i, h in enumerate(hits) ]
system_prompt = ( "你是企业智能助手「小千」,回答简洁、专业、友好。" + (("\n\n" + context_block) if context_block else "") )
payload = { "model": CHAT_MODEL, "messages": [ {"role": "system", "content": system_prompt}, *[m.model_dump() for m in req.messages], ], "max_tokens": req.max_tokens, "stream": True, "enable_thinking": False, } headers = {"Authorization": f"Bearer {LLM_API_KEY}"}
async def event_stream(): async with httpx.AsyncClient(timeout=120) as client: async with client.stream("POST", CHAT_URL, json=payload, headers=headers) as r: if r.status_code != 200: body = (await r.aread()).decode("utf-8", "ignore") yield f"data: {json.dumps({'error': body})}\n\n" return async for line in r.aiter_lines(): if line.startswith("data:"): chunk = line[5:].strip() if chunk == "[DONE]": break try: delta = json.loads(chunk)["choices"][0]["delta"].get("content", "") except Exception: continue if delta: yield f"data: {json.dumps({'content': delta}, ensure_ascii=False)}\n\n" if sources: yield f"data: {json.dumps({'sources': sources}, ensure_ascii=False)}\n\n" yield "data: [DONE]\n\n"
return StreamingResponse( event_stream(), media_type="text/event-stream", headers={"Cache-Control": "no-cache", "X-Accel-Buffering": "no"}, )"""轻量级本地向量知识库- 不依赖外部数据库:向量存 numpy 文件、元数据存 JSON- 中文友好切分(语义边界 + 重叠);余弦相似度检索- 生产环境可平滑替换为 Qdrant/Milvus,接口不变"""import jsonimport osimport re
import numpy as np
STORE_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "data")INDEX_PATH = os.path.join(STORE_DIR, "kb_index.npz")META_PATH = os.path.join(STORE_DIR, "kb_meta.json")
def chunk_text(text: str, size: int = 280, overlap: int = 60) -> list[str]: """按长度切分,并在标点/换行边界尽量断开,保留 overlap 重叠。""" text = re.sub(r"\r\n?", "\n", text) text = re.sub(r"\n{3,}", "\n\n", text).strip() if len(text) <= size: return [text] if text else []
chunks, start = [], 0 while start < len(text): end = min(start + size, len(text)) if end < len(text): # 在窗口后 1/3 内寻找语义边界 window = text[start + size // 2 : end] for sep in ["\n\n", "。", "!", "?", ";", "\n", ","]: pos = window.rfind(sep) if pos != -1: end = start + size // 2 + pos + len(sep) break chunk = text[start:end].strip() if chunk: chunks.append(chunk) if end >= len(text): break # 已覆盖到结尾,防止 start 以 1 字符步进死循环产生大量碎块 start = max(end - overlap, start + 1) # 防死循环 return chunks
class VectorStore: def __init__(self): os.makedirs(STORE_DIR, exist_ok=True) self.vectors = None # ndarray (n, dim) self.meta = [] # [{"doc_id","name","chunk_id","text"}]
def load(self) -> bool: if os.path.exists(INDEX_PATH) and os.path.exists(META_PATH): data = np.load(INDEX_PATH) self.vectors = data["vectors"] with open(META_PATH, encoding="utf-8") as f: self.meta = json.load(f) return True return False
def save(self): if self.vectors is not None: np.savez_compressed(INDEX_PATH, vectors=self.vectors) with open(META_PATH, "w", encoding="utf-8") as f: json.dump(self.meta, f, ensure_ascii=False)
@property def count(self) -> int: return 0 if self.vectors is None else len(self.vectors)
def add(self, doc_name: str, chunks: list[str], vectors: list[list[float]]) -> int: new_vec = np.array(vectors, dtype=np.float32) self.vectors = new_vec if self.vectors is None else np.vstack([self.vectors, new_vec]) base = max((m["doc_id"] for m in self.meta), default=0) + 1 for i, c in enumerate(chunks): self.meta.append({"doc_id": base, "name": doc_name, "chunk_id": i, "text": c}) self.save() return len(chunks)
def search(self, query_vec: list[float], top_k: int = 4) -> list[dict]: if self.count == 0: return [] q = np.array(query_vec, dtype=np.float32) scores = self.vectors @ q / ( np.linalg.norm(self.vectors, axis=1) * np.linalg.norm(q) + 1e-9 ) top = np.argsort(scores)[::-1][:top_k] hits = [] for i in top: if scores[i] < 0.45: # 相似度过低的丢弃(防弱相关上下文诱发幻觉) continue m = dict(self.meta[i]) m["score"] = round(float(scores[i]), 4) hits.append(m) return hits
def clear(self): self.vectors = None self.meta = [] for p in (INDEX_PATH, META_PATH): if os.path.exists(p): os.remove(p)#!/bin/bash# 用法:代码放 /opt/qwen3-demo 后,root 执行:# LLM_API_KEY=sk-xxx ACCESS_TOKEN=你的令牌 bash deploy.shset -eif [ -z "$LLM_API_KEY" ] || [ -z "$ACCESS_TOKEN" ]; then echo "用法: LLM_API_KEY=sk-xxx ACCESS_TOKEN=你的令牌 bash deploy.sh"; exit 1fi[ "$(id -u)" != "0" ] && { echo "请用 root 执行"; exit 1; }[ ! -d /opt/qwen3-demo/backend ] && { echo "请先把代码上传到 /opt/qwen3-demo"; exit 1; }
echo "==> 1/5 安装基础软件"apt update -y && apt install -y python3-pip nginx curl
echo "==> 2/5 配置 2G swap"if [ ! -f /swapfile ]; then fallocate -l 2G /swapfile && chmod 600 /swapfile mkswap /swapfile && swapon /swapfile grep -q swapfile /etc/fstab || echo '/swapfile none swap sw 0 0' >> /etc/fstabfi
echo "==> 3/5 安装后端依赖"cd /opt/qwen3-demo/backendpip3 install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
echo "==> 4/5 配置 systemd 常驻服务"cat > /etc/systemd/system/qwen-api.service <<EOF[Unit]Description=Qwen3 RAG Demo APIAfter=network.target[Service]User=rootWorkingDirectory=/opt/qwen3-demo/backendEnvironment=LLM_API_KEY=${LLM_API_KEY}Environment=QWEN_MODEL=${QWEN_MODEL:-qwen-turbo}Environment=ACCESS_TOKEN=${ACCESS_TOKEN}ExecStart=/usr/local/bin/uvicorn main:app --host 127.0.0.1 --port 8000Restart=alwaysRestartSec=5[Install]WantedBy=multi-user.targetEOFsystemctl daemon-reload && systemctl enable --now qwen-api
echo "==> 5/5 配置 Nginx(前端 + 反向代理)"cat > /etc/nginx/sites-available/default <<'EOF'server { listen 80 default_server; root /var/www/html; index index.html; location /api/ { proxy_pass http://127.0.0.1:8000; proxy_http_version 1.1; proxy_set_header Connection ""; proxy_buffering off; # SSE 流式必须关缓冲 proxy_read_timeout 300s; }}EOFcp /opt/qwen3-demo/frontend/index.html /var/www/html/index.htmlnginx -t && systemctl reload nginxsleep 2curl -s http://127.0.0.1:8000/api/health && echo ""IP=$(curl -s --connect-timeout 3 ifconfig.me || echo 服务器IP)echo "部署完成!浏览器访问: http://${IP}/?token=${ACCESS_TOKEN}"// ① 后端地址与令牌:默认同源(Nginx 反代),可用 URL 参数覆盖const params = new URLSearchParams(location.search);const API = params.get("api") || (location.protocol === "file:" ? "http://localhost:8000" : location.origin);const TOKEN = params.get("token") || "";const authHeaders = TOKEN ? { "X-Access-Token": TOKEN } : {};
// ② SSE 流式读取(打字机效果核心)const reader = resp.body.getReader();const decoder = new TextDecoder();let buf = "", full = "";while (true) { const { done, value } = await reader.read(); if (done) break; buf += decoder.decode(value, { stream: true }); let idx; while ((idx = buf.indexOf("\n\n")) >= 0) { const line = buf.slice(0, idx).trim(); buf = buf.slice(idx + 2); if (!line.startsWith("data:")) continue; const data = line.slice(5).trim(); if (data === "[DONE]") continue; const j = JSON.parse(data); if (j.error) throw new Error(j.error); if (j.sources) { addSources(j.sources); continue; } // 引用来源标签 full += j.content || ""; bot.textContent = full; // 逐字渲染 chatEl.scrollTop = chatEl.scrollHeight; }}
// ③ 多轮对话记忆:滑动窗口只保留最近 10 轮,控制上下文成本body: JSON.stringify({ messages: history.slice(-10) })
// ④ 设备健康日报按钮(v7:令牌同时放 URL 参数和请求头,两种鉴权接口都兼容)document.getElementById("reportBtn").onclick = async () => { const el = addMsg("bot", "📊 正在分析设备数据并生成日报…"); const r = await fetch(API + "/api/report?token=" + encodeURIComponent(TOKEN), { headers: authHeaders }); const j = await r.json(); el.textContent = "📊 设备健康日报(最近 24 小时)\n\n" + (j.report || JSON.stringify(j));};"""设备健康日报模块(融合进 qwen3-demo)链路:传感器 CSV → 清洗 → 双规则异常检测 → 汇总 24h 指标 → 检索设备手册处置建议 → 大模型生成自然语言日报"""import jsonimport os
import numpy as npimport pandas as pd
# 数据文件默认放在 qwen3-demo/backend/data/ 下,可用环境变量覆盖DATA_CSV = os.getenv("EQUIPMENT_CSV", os.path.join(os.path.dirname(os.path.abspath(__file__)), "data", "equipment_data.csv"))MANUAL = os.getenv("EQUIPMENT_MANUAL", os.path.join(os.path.dirname(os.path.abspath(__file__)), "data", "设备手册.txt"))
WINDOW, SIGMA = 48, 3.0THRESH = {"vib_high": 4.5, "temp_high": 75.0}
LLM_BASE_URL = os.getenv("LLM_BASE_URL", "https://dashscope.aliyuncs.com/compatible-mode/v1")LLM_API_KEY = os.getenv("LLM_API_KEY", "")MODEL = os.getenv("QWEN_MODEL", "qwen-turbo")
def _clean(df: pd.DataFrame) -> pd.DataFrame: df = df.drop_duplicates() for col in ["temperature", "vibration", "current"]: df.loc[df[col] == 0, col] = np.nan # 0 值是断线,不是真 0 df = df.sort_values(["machine_id", "timestamp"]) for col in ["temperature", "vibration", "current"]: df[col] = df.groupby("machine_id")[col].transform( # transform 不丢分组列 lambda s: s.interpolate(limit_direction="both").fillna(s.median()) ) return df
def _detect(df: pd.DataFrame) -> pd.DataFrame: def rolling_sigma(g: pd.DataFrame) -> pd.DataFrame: for col in ["temperature", "vibration"]: m = g[col].rolling(WINDOW, min_periods=24).mean() s = g[col].rolling(WINDOW, min_periods=24).std() g[f"{col}_z"] = ((g[col] - m) / s.replace(0, np.nan)).round(2) g["sigma_alert"] = (g["temperature_z"].abs() > SIGMA) | (g["vibration_z"].abs() > SIGMA) return g
df = pd.concat([rolling_sigma(g) for _, g in df.groupby("machine_id")]).sort_index() df["rule_alert"] = (df["temperature"] > THRESH["temp_high"]) | (df["vibration"] > THRESH["vib_high"]) df["alert"] = df["rule_alert"] | df["sigma_alert"] return df
def build_summary() -> dict: """读取设备数据,完成清洗与检测,汇总最近 24 小时指标。""" if not os.path.exists(DATA_CSV): return {"error": f"未找到设备数据文件:{DATA_CSV}"} df = _detect(_clean(pd.read_csv(DATA_CSV, parse_dates=["timestamp"]))) latest = df[df["timestamp"] >= df["timestamp"].max() - pd.Timedelta(hours=23)] rows = [] for mid, g in latest.groupby("machine_id"): prev = df[(df["machine_id"] == mid) & (df["timestamp"] < df["timestamp"].max() - pd.Timedelta(hours=24))] vib_now, vib_prev = g["vibration"].mean(), prev["vibration"].mean() item = { "设备": mid, "平均温度": round(float(g["temperature"].mean()), 1), "最高振动": round(float(g["vibration"].max()), 2), "振动环比": f"{(vib_now - vib_prev) / vib_prev * 100:+.1f}%", "产量": int(g["output_count"].sum()), "异常次数": int(g["alert"].sum()), } if item["异常次数"] >= 8 or item["最高振动"] > THRESH["vib_high"] + 0.8: item["风险"] = "高风险" elif item["异常次数"] >= 3 or item["最高振动"] > THRESH["vib_high"] - 0.5: item["风险"] = "关注" else: item["风险"] = "正常" rows.append(item) return {"周期": "最近 24 小时", "设备": rows}
def lookup_manual(keyword: str) -> str: """从设备手册中按关键词取处置建议(轻量检索,生产可换 RAG 向量检索)。""" if not os.path.exists(MANUAL): return "" text = open(MANUAL, encoding="utf-8").read() for block in text.split("\n\n"): if keyword in block: return block.strip()[:300] return ""
async def generate_report_text(summary: dict) -> str: """调用大模型把结构化指标翻译成自然语言日报。""" import httpx body = json.dumps(summary, ensure_ascii=False, indent=2) hints = [] for m in summary.get("设备", []): if m["风险"] != "正常": tip = lookup_manual("主轴过热") if m["平均温度"] > 60 else lookup_manual("振动") if tip: hints.append(f"【{m['设备']}】参考手册建议:{tip}") prompt = ( "你是工厂设备管理员助手。根据以下设备监控数据,写一份给车间主任看的《设备健康日报》。\n" "要求:① 先一句话说总体情况;② 高风险设备单独列出问题和建议动作;" "③ 语言简洁、面向一线,不要堆砌术语;④ 不超过 300 字。\n\n" f"监控数据:\n{body}\n" + ("\n参考建议:\n" + "\n".join(hints) if hints else "") ) if not LLM_API_KEY: return "(未配置 LLM_API_KEY,以下为结构化数据)\n\n" + body try: async with httpx.AsyncClient(timeout=120) as client: r = await client.post( f"{LLM_BASE_URL}/chat/completions", headers={"Authorization": f"Bearer {LLM_API_KEY}"}, json={"model": MODEL, "messages": [{"role": "user", "content": prompt}], "enable_thinking": False}, ) r.raise_for_status() return r.json()["choices"][0]["message"]["content"] except Exception as e: return f"(模型调用失败:{e})以下是结构化数据:\n\n{body}"上线验收用固定测试文档出 4 道题,2 对 2 错,逐步定位修复:
/api/debug 调试接口透视检索中间产物 → 正确片段其实在候选里(0.56 分)kb_chunks=67 异常(1141 字符应为 ~7 块)→ 逐轮追踪切分循环固定测试集做回归验证,每改一处重测全部用例; 排查遵循”先看中间产物,再改参数”;RAG 的可靠性来自检索质量与数据管道,而不只是模型。
用途:A5 验收测试与第九章回归测试的标准测试文档。把下面全文复制保存为
测试文档-设备维护手册.txt,通过「📚 知识库」上传即可复现全部测试用例。这份文档同时是日报模块读取处置建议的来源(backend/data/设备手册.txt内容与之相同)。
CNC-8800 数控加工中心 设备维护手册(测试版)
第一章 日常点检规范
1.1 每日点检项目开机前必须完成以下五项检查:(1)检查液压油位,油位应处于油窗刻度的 1/2 至 2/3 之间;(2)检查冷却液浓度,正常范围为 5%-8%,低于 4% 需补加原液;(3)检查气压表读数,主轴气动夹具压力应保持在 0.6-0.8 MPa;(4)检查导轨润滑油泵工作状态,油位低于刻度 1/4 时立即加注 46 号导轨油;(5)Listen 检查(听音检查):主轴空运转 3 分钟,无异响、无异常振动方可开始加工。
1.2 每周点检项目每周一早班对排屑器进行清理,清除铁屑积存;检查电柜风扇滤网,积尘厚度超过 2mm 时用压缩空气(0.4MPa 以下)吹扫;检查各轴限位开关动作是否灵活。
第二章 常见故障处理
2.1 主轴过热报警(ALM-4021)故障现象:主轴温度传感器读数超过 65℃,系统触发 ALM-4021 报警。处理步骤:(1)先停机 15 分钟,让主轴自然冷却;(2)检查主轴冷却水箱水位,低于下限则加注专用冷却液(型号 HFC-25);(3)检查冷却泵是否运转,若泵不转,检查泵电机热继电器是否跳脱,复位后重启;(4)若以上正常仍报警,检查主轴轴承,振动值超过 4.5mm/s 时联系设备科更换轴承,切勿强行开机。
2.2 加工尺寸超差故障现象:加工孔位偏差超过 0.02mm。处理步骤:(1)检查工件装夹是否松动,重新装夹并对刀;(2)检查丝杠反向间隙,超过 0.015mm 时在系统参数中做反向间隙补偿;(3)检查环境温度,车间温度偏离 20℃±5℃ 范围时精度受影响,夏季高温时段建议安排在早晚加工高精度件。
2.3 气动夹具夹不紧故障现象:夹紧压力显示正常但工件打滑。处理步骤:(1)检查夹爪齿面磨损,磨损超标更换夹爪;(2)检查气路三联件滤芯,积水过多会顶开安全阀导致实际压力不足,排水并更换滤芯。
第三章 安全操作红线(严禁事项)
(1)严禁在主轴旋转时打开防护门;(2)严禁戴手套操作机床;(3)严禁擅自修改系统参数,参数修改必须由设备科授权工程师执行并记录;(4)严禁冷却液溅入电柜,电柜门必须常闭锁紧;(5)发生异响、焦糊味、冒烟时立即按急停并断开电柜总电源,撤离并上报班组长。
第四章 保养周期表
主轴轴承:每 6000 小时检查一次振动值,超过 4.5mm/s 更换;丝杠润滑:每 500 小时加注锂基润滑脂;冷却液更换:每 3 个月整体更换一次;电柜除尘:每季度专业除尘一次;精度校验:每半年做一次定位精度检测(激光干涉仪),重复定位精度标准 ±0.005mm。固定测试集,每改一处参数/代码就重测全部 4 题。3 题考”文档里有”,1 题考”文档里没有”(防幻觉)。
| # | 测试问题 | 预期正确回答 | 考察点 | 实测历史 |
|---|---|---|---|---|
| 1 | 每日开机前要完成哪几项点检? | 5 项:液压油位、冷却液浓度、气压表、导轨润滑油泵、听音检查 | 信息完整性(多要点并列) | ✅ 一次通过 |
| 2 | 冷却液浓度低于多少需要补加原液? | 低于 4%(正常范围 5%-8%) | 精确数值检索 | ❌→✅ 暴露切分器 bug(见第九章问题 B) |
| 3 | 主轴过热报警怎么处理? | 停机冷却 15 分钟→查水位加 HFC-25→查冷却泵热继电器→振动超 4.5mm/s 换轴承 | 多步骤流程复述 | ✅ 一次通过 |
| 4 | 公司年假有几天? | 必须回答”知识库中没有相关内容”(文档无此信息) | 防幻觉:拒绝编造 | ❌→✅ 曾编造”5 天”,阈值提至 0.45 后正确拒答(见第九章问题 A) |
设计说明:第 2 题的”4%“故意埋在长段落中间,专测切分与召回质量;第 4 题是文档外的”陷阱题”,专测模型会不会编造。四题全绿 = RAG 全链路(解析→切分→向量化→检索→生成→拒答)验收通过。
笔记完 · 配套代码:qwen3-demo
